L'Anatomia della Lingua nella Macchina:
Perché l'IA Fallisce nei Dialetti Rari e la Fisica degli Spazi Vettoriali
I modelli di frontiera promettono l'omniscienza, ma di fronte a lingue alpine e dialetti storici a basse risorse il castello statistico crolla. Un'analisi rigorosa su come la tokenizzazione frantuma la semantica prima ancora che il Transformer calcoli il suo primo peso.
"Fri béscht wen noadengscht dine oalte woa hein de lebta kät fer d’friheit z’erhoalte."
(Sei libero quando ricordi i tuoi vecchi, che hanno dato la vita per mantenere la libertà).
1. Il Punto Cieco della Rivoluzione dei Modelli Linguistici
Viviamo l'euforia dei modelli generativi di frontiera. Llama 3, Claude, Gemini, GPT-4: sistemi dotati di centinaia di miliardi di parametri capaci di redigere atti legali, risolvere complessi problemi di programmazione e tradurre decine di lingue moderne con una fluidità quasi indistinguibile da quella umana.
Questa apparente onniscenza ha generato un consenso frettoloso nel mercato tecnologico: la convinzione che il linguaggio umano, in tutta la sua ampiezza storica e geografica, sia stato finalmente risolto dalla forza bruta di trilioni di token estratti dal web moderno.
Nei nostri progetti dedicati alla trascrizione, all'indicizzazione e all'intelligenza applicata sui manoscritti antichi e sul patrimonio storico, ci confrontiamo quotidianamente con l'opposto di questa premessa. Quando abbandoniamo le grandi lingue egemoni del digitale ed entriamo nel territorio delle lingue a basse risorse (low-resource languages) come i dialetti alpini Walser (Titsch) e il Francoprovenzale (Patois), il castello statistico di queste intelligenze artificiali crolla istantaneamente.
Ciò che la maggior parte degli sviluppatori etichetta genericamente come "allucinazione del modello" non è un banale errore creativo, né un difetto del motore OCR, né tantomeno un limite superabile con semplici tecniche di prompt engineering o architetture RAG superficiali.
Il problema è fondazionale: risiede nell'esatto millisecondo in cui una parola stampata o manoscritta attraversa il primo livello di una rete neurale e tenta di trasformarsi in una coordinata matematica nello spazio latente.
2. Dalla Grafia al Concetto: La Catena Meccanica di un LLM
Per comprendere perché questo accade e perché questa sfida ci ha portato recentemente a una tavola rotonda a porte chiuse con i leader globali di IA di AWS e NVIDIA a Berlino, dobbiamo aprire il cofano dei modelli ed esaminare la fisica matematica dei loro tre pilastri fondamentali: il Tokenizer, la Matrice di Embedding e lo Spazio Vettoriale Multidimensionale.
Nonostante il senso comune, un'Intelligenza Artificiale generativa non pensa in termini di linguaggio naturale. Le reti neurali sono essenzialmente calcolatori probabilistici basati sull'algebra lineare e sulla moltiplicazione di matrici ad alta densità. Affinché un carattere umano venga elaborato, esso è sottoposto a una rigorosa catena di quattro fasi sequenziali:
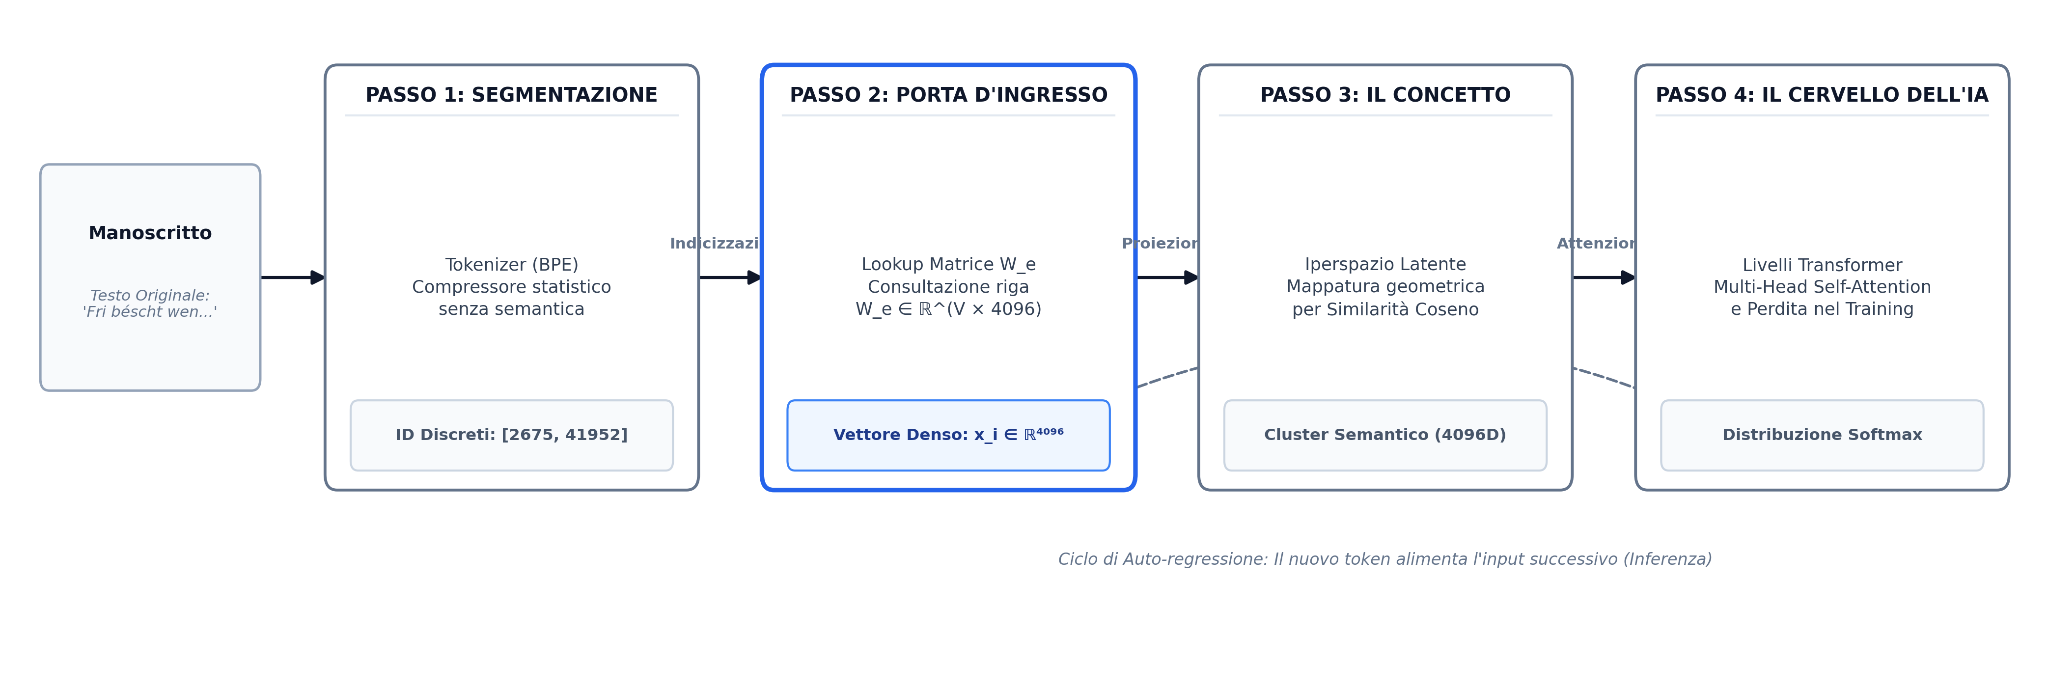
Passo 1: Il Tokenizer e la Segmentazione Meccanica
Il primo punto di contatto con il testo è il Tokenizer. Si tratta di un software completamente isolato e disaccoppiato dal cervello della rete neurale. Opera attraverso una tabella statica basata su algoritmi di compressione statistica, tra cui i più diffusi sono il Byte-Pair Encoding (BPE) o il SentencePiece.
Il tokenizer non possiede alcuna nozione di semantica, grammatica o emozione: è puramente un compressore e un riduttore di dimensionalità testuale. Inizia osservando singoli caratteri (byte isolati) e, analizzando terabyte di testo durante la sua creazione, unisce iterativamente le coppie di caratteri più frequenti sul web. Se la sequenza di lettere c, a, s, a compare milioni di volte, l'algoritmo fonde queste lettere creando un blocco unico: la parola intera "casa", assegnandole un numero identificativo statico (ID).
In Llama 3 (8B), ad esempio, questo vocabolario è finito e conta esattamente 128.256 token possibili. Il tokenizer non è altro che un indice da 0 a 128.255. La parola inglese "free" viene indicizzata come Token 2675, mentre la parola italiana "libero" è indicizzata come Token 1542 e 80586. Tra questi numeri non esiste alcuna relazione matematica diretta; sono solo cassetti numerati in una cassettiera meccanica.
📊 Tabella Comparativa di Frontiera: Dimensioni della Matrice d'Ingresso We
Passo 2: La Matrice di Embedding (We) e la Porta d'Ingresso
Una volta che il testo è stato frammentato e convertito in una lista di ID interi, raggiunge la porta d'ingresso della rete neurale sulla GPU. È qui che risiede la Matrice di Embedding di Input (We), formalmente definita come:
Dove V è la dimensione del vocabolario (il numero di righe) e dmodel è la dimensione dello spazio latente (il numero di colonne). In questa fase il modello non esegue calcoli complessi: compie un'operazione diretta di Lookup (consultazione). Ricevendo il token 2675 ("free"), il modello accede semplicemente alla riga 2675 di questa tabella e scarica un vettore denso continuo:
Passo 3: L'Iperspazio Latente e le Coordinate Semantiche
Cosa significano realmente questi 4.096 numeri decimali? Sono una coordinata nello spazio. Pensiamo alla geometria fondamentale:
- Con 2 numeri (x, y), posizioniamo un punto su un piano 2D (una mappa stradale).
- Con 3 numeri (x, y, z), posizioniamo un oggetto nello spazio fisico tridimensionale.
- Con 4.096 numeri, l'IA posiziona un CONCETTO in un iperspazio di 4.096 dimensioni.
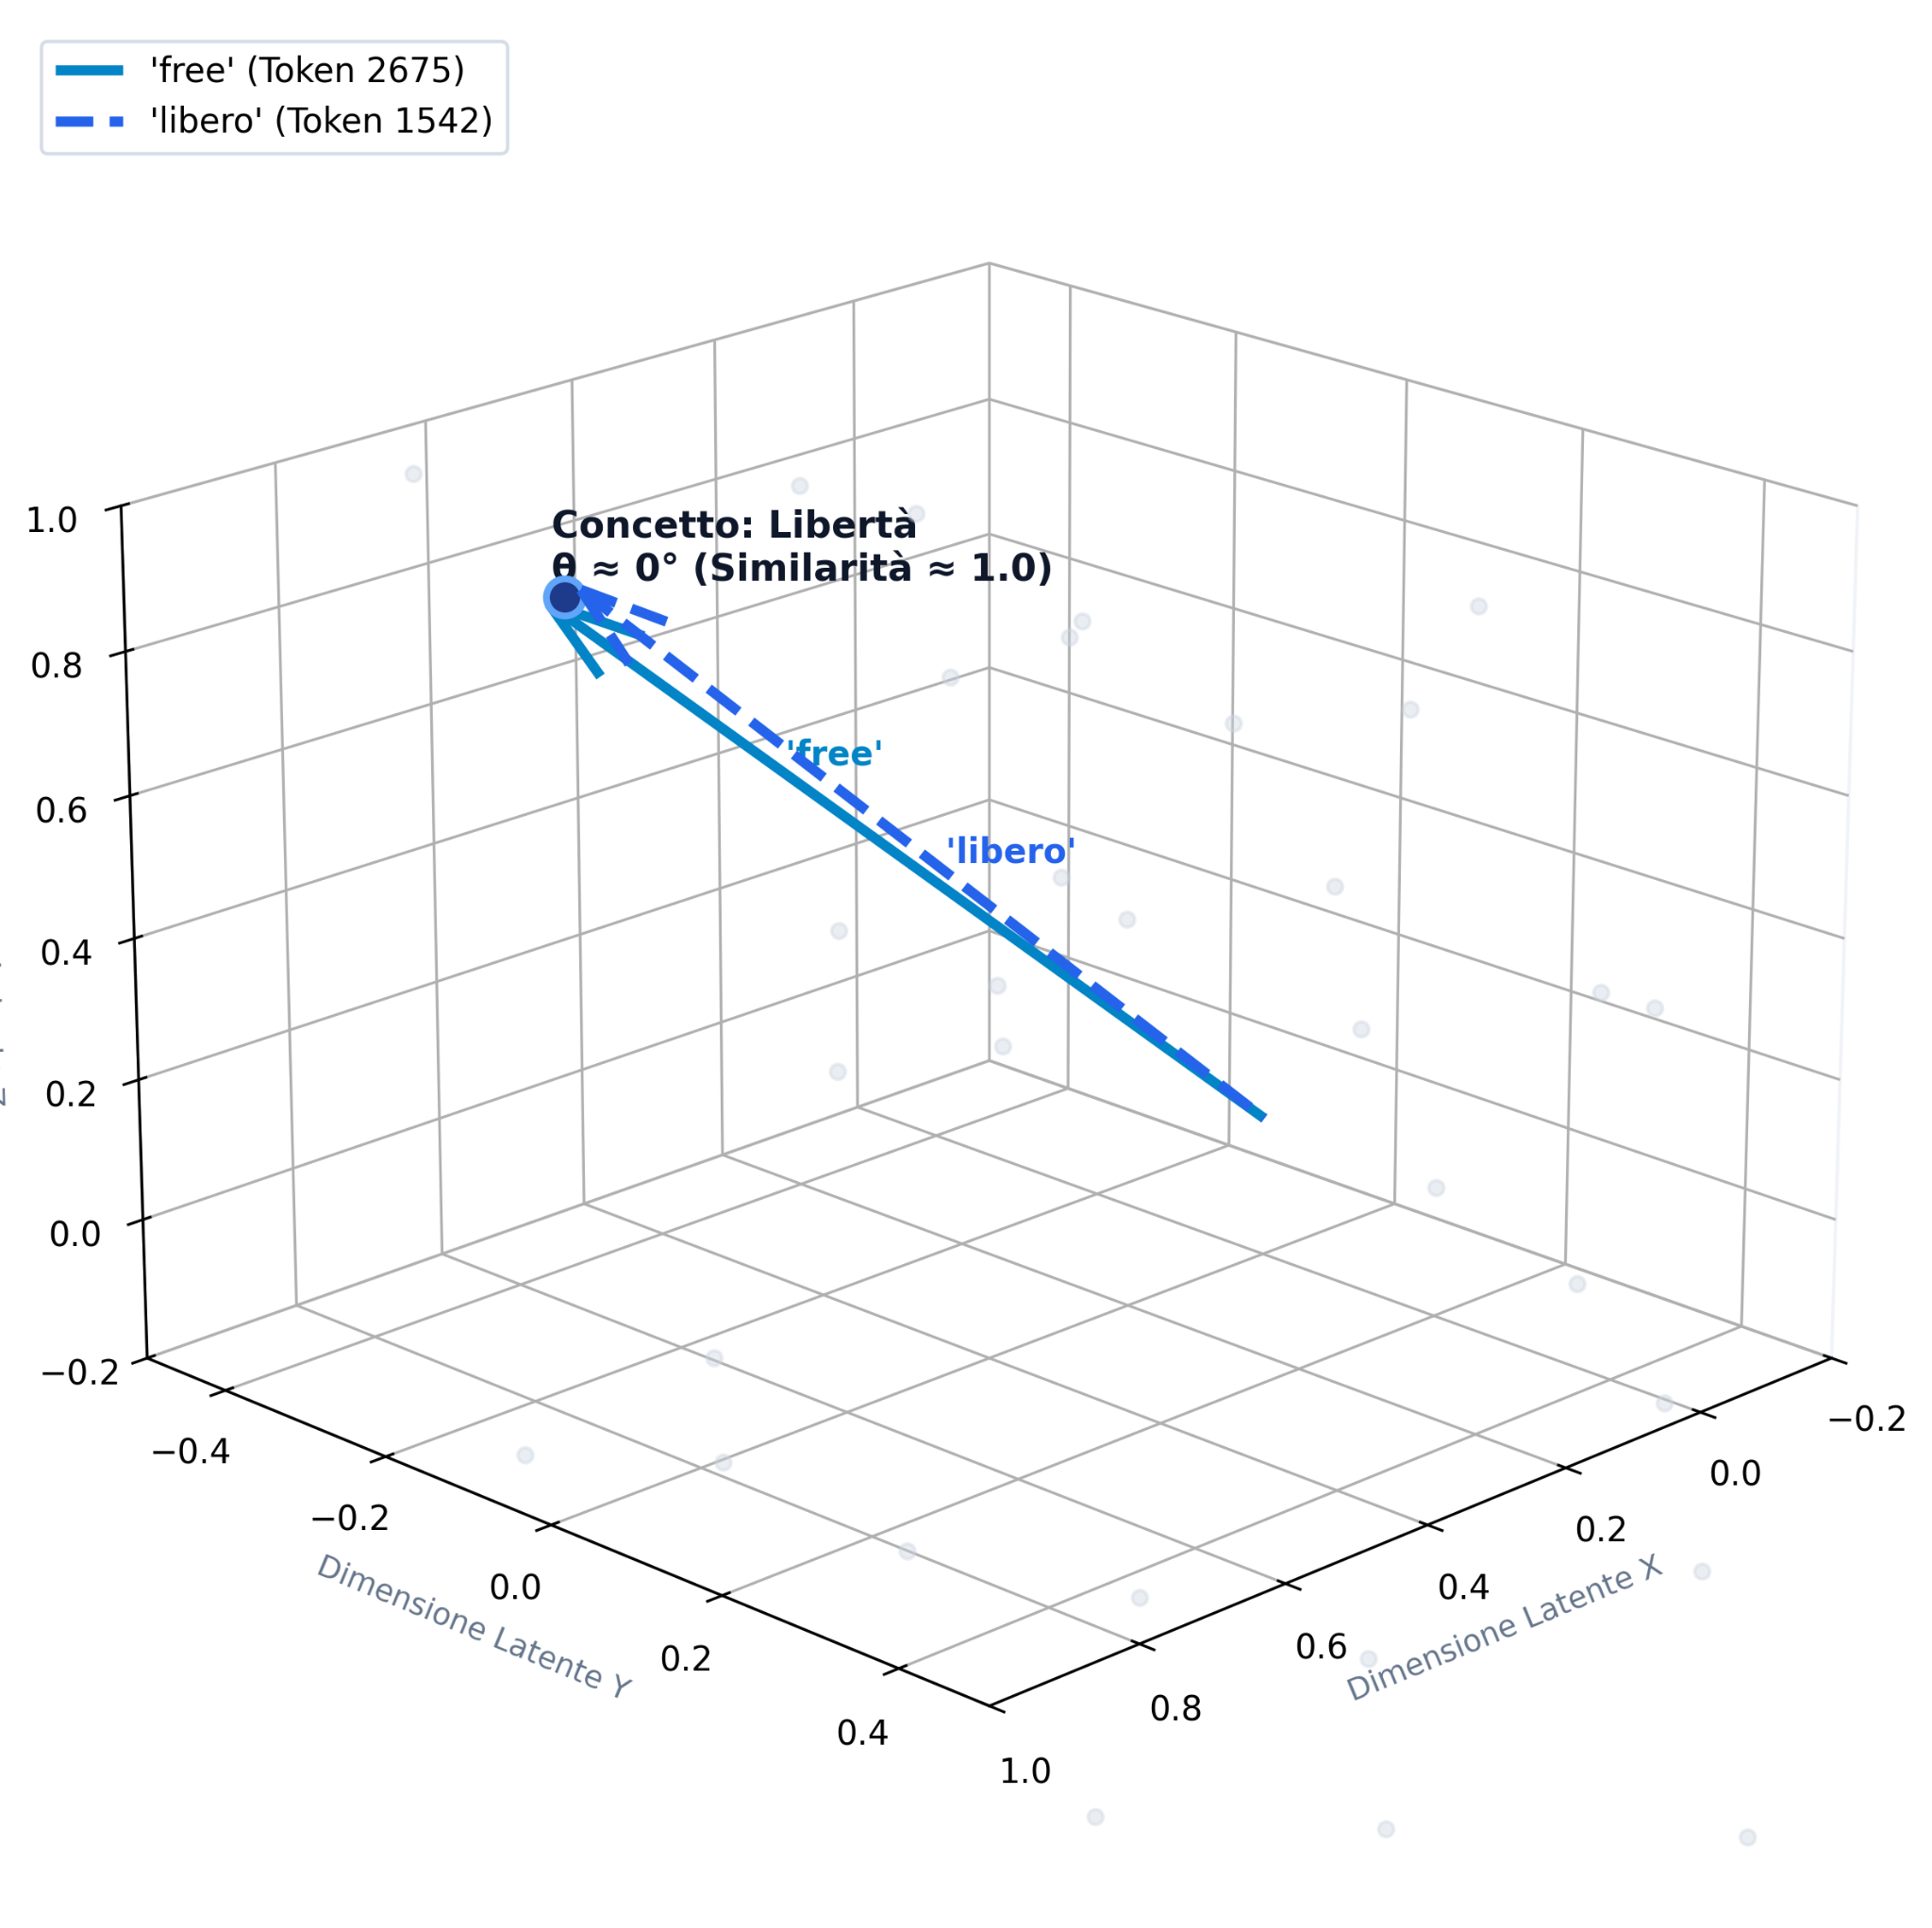
Ognuna di queste 4.096 dimensioni funge da asse sottile e astratto appreso durante l'addestramento: tempo verbale, formalità, relazioni di genere, contesto storico e affinità semantica. Quando calcoliamo la distanza angolare tra il vettore di "free" e il vettore di "libero" attraverso la Similarità Coseno, l'angolo tra essi è praticamente zero:
L'IA non ha bisogno di "tradurre" mentalmente da una lingua all'altra: nell'iperspazio geometrico, "free" e "libero" puntano alla medesima coordinata. Il concetto di "Libertà" abita una regione fissa della geometria interna del modello.
Passo 4: Il Meccanismo di Attenzione e il Calcolo di Probabilità
Con i vettori posizionati nello spazio geometrico, il flusso raggiunge finalmente il nucleo del modello: i livelli del Transformer. Qui si compiono i due processi cardine:
- Calcolo della Self-Attention (Auto-Attenzione): Il modello non elabora parole isolate. Attraverso matrici di attenzione (Multi-Head Attention), ciascun vettore proietta antenne e dialoga contemporaneamente con tutti gli altri vettori della frase, ponderando quali termini siano più rilevanti tra loro nel contesto storico specifico.
- Proiezione di Uscita e Probabilità (Softmax): Attraversate decine di strati neurali profondi, il vettore risultante raggiunge il livello finale di proiezione lineare (LM Head). Il modello applica la funzione matematica Softmax, generando una distribuzione di probabilità su tutte le opzioni del vocabolario per rispondere a una domanda statistica: qual è il prossimo token atteso?
⚠️ La Sintesi della Catena: La Dipendenza Assoluta dalle Fondamenta
Ripercorrendo questi quattro passaggi, la fisica interna di un LLM svela una verità inevitabile: la catena è strettamente causale e cumulativa. Il Transformer è spesso definito "il cervello della macchina", ma è del tutto cieco al mondo reale: elabora esclusivamente i vettori che gli vengono consegnati dalla matrice di embedding d'ingresso. Se la rappresentazione alla porta d'ingresso è corrotta, il Transformer calcolerà semplicemente attenzione su puro rumore statistico.
3. L'Esperimento Empirico: Il Collasso nel Dialetto Titsch (Walser)
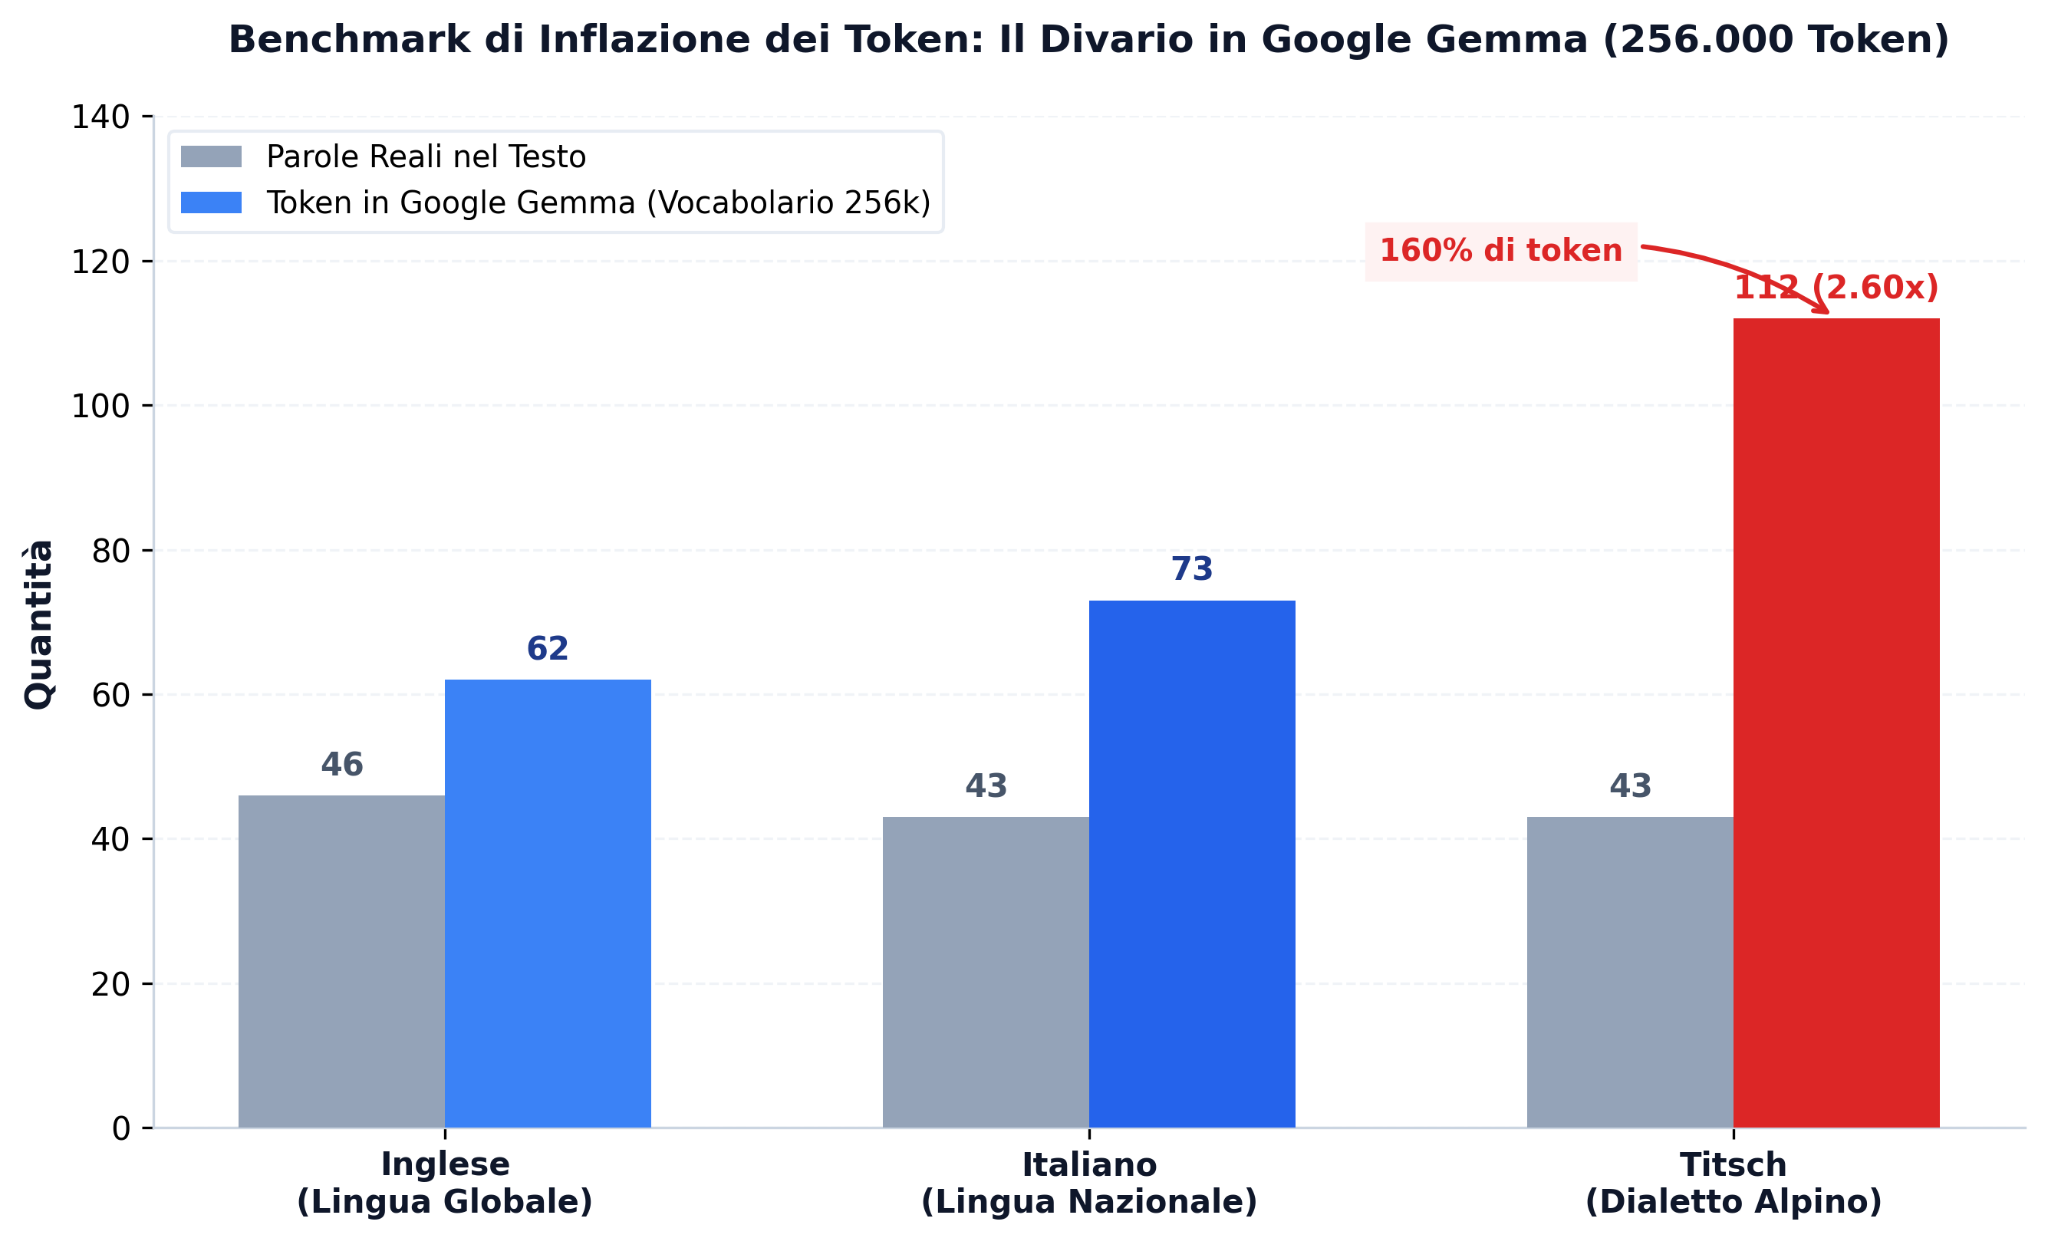
È davanti ai numeri colossali del settore che la nostra ipotesi trova conferma nella pratica: anche quando Google sviluppa una matrice monumentale di 256.000 token (consumando oltre 1,17 miliardi di parametri solo all'ingresso), le lingue storiche a basse risorse rimangono completamente invisibili al modello.
Per dimostrare questo fenomeno senza dipendere da supposizioni teoriche, abbiamo progettato un test empirico di controllo utilizzando una strofa della poesia storica "D’friheit" (La Libertà), scritta nel dialetto germanico-alpino Titsch (Walser) dalla poetessa Luciana Favre, a Gressoney:
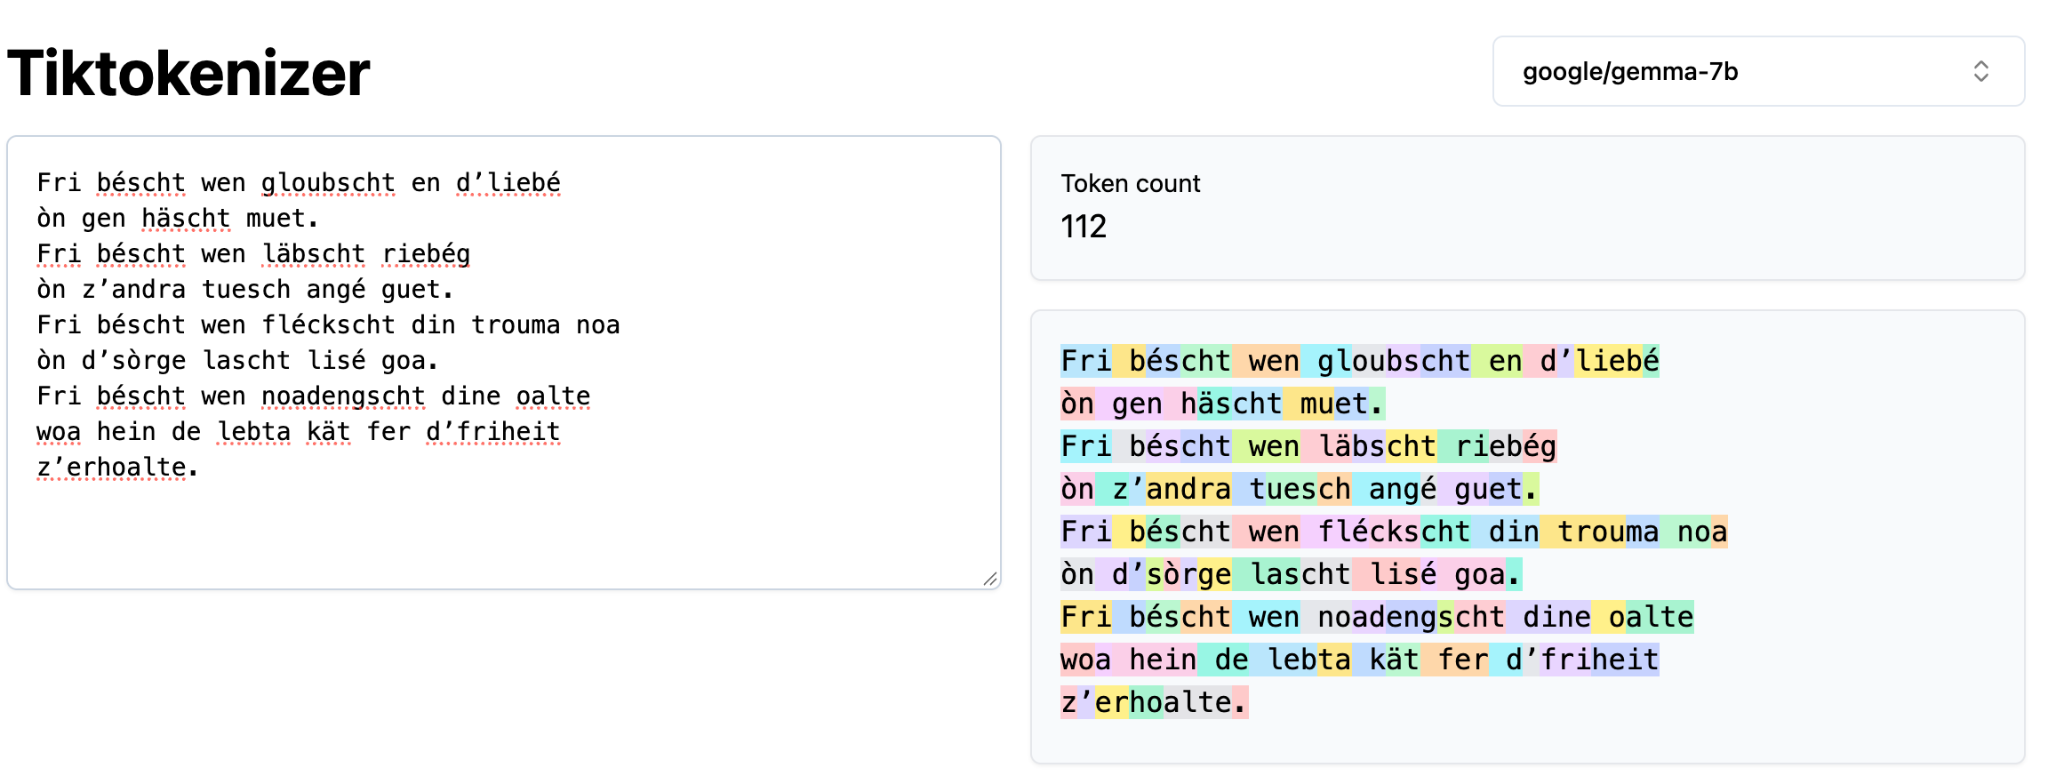
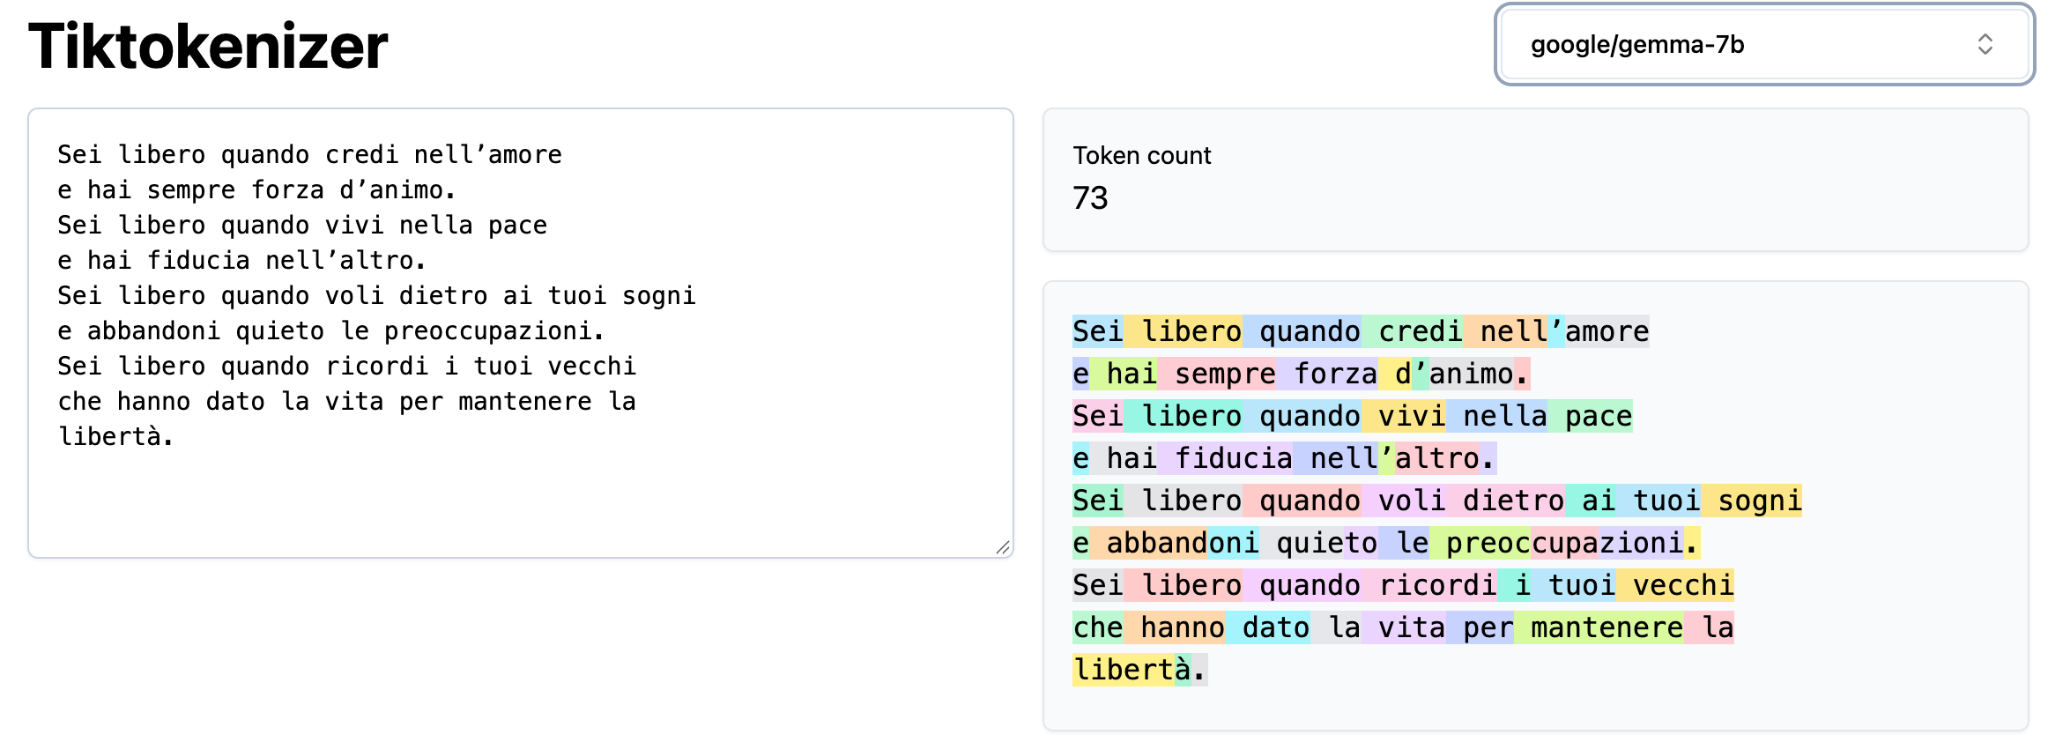
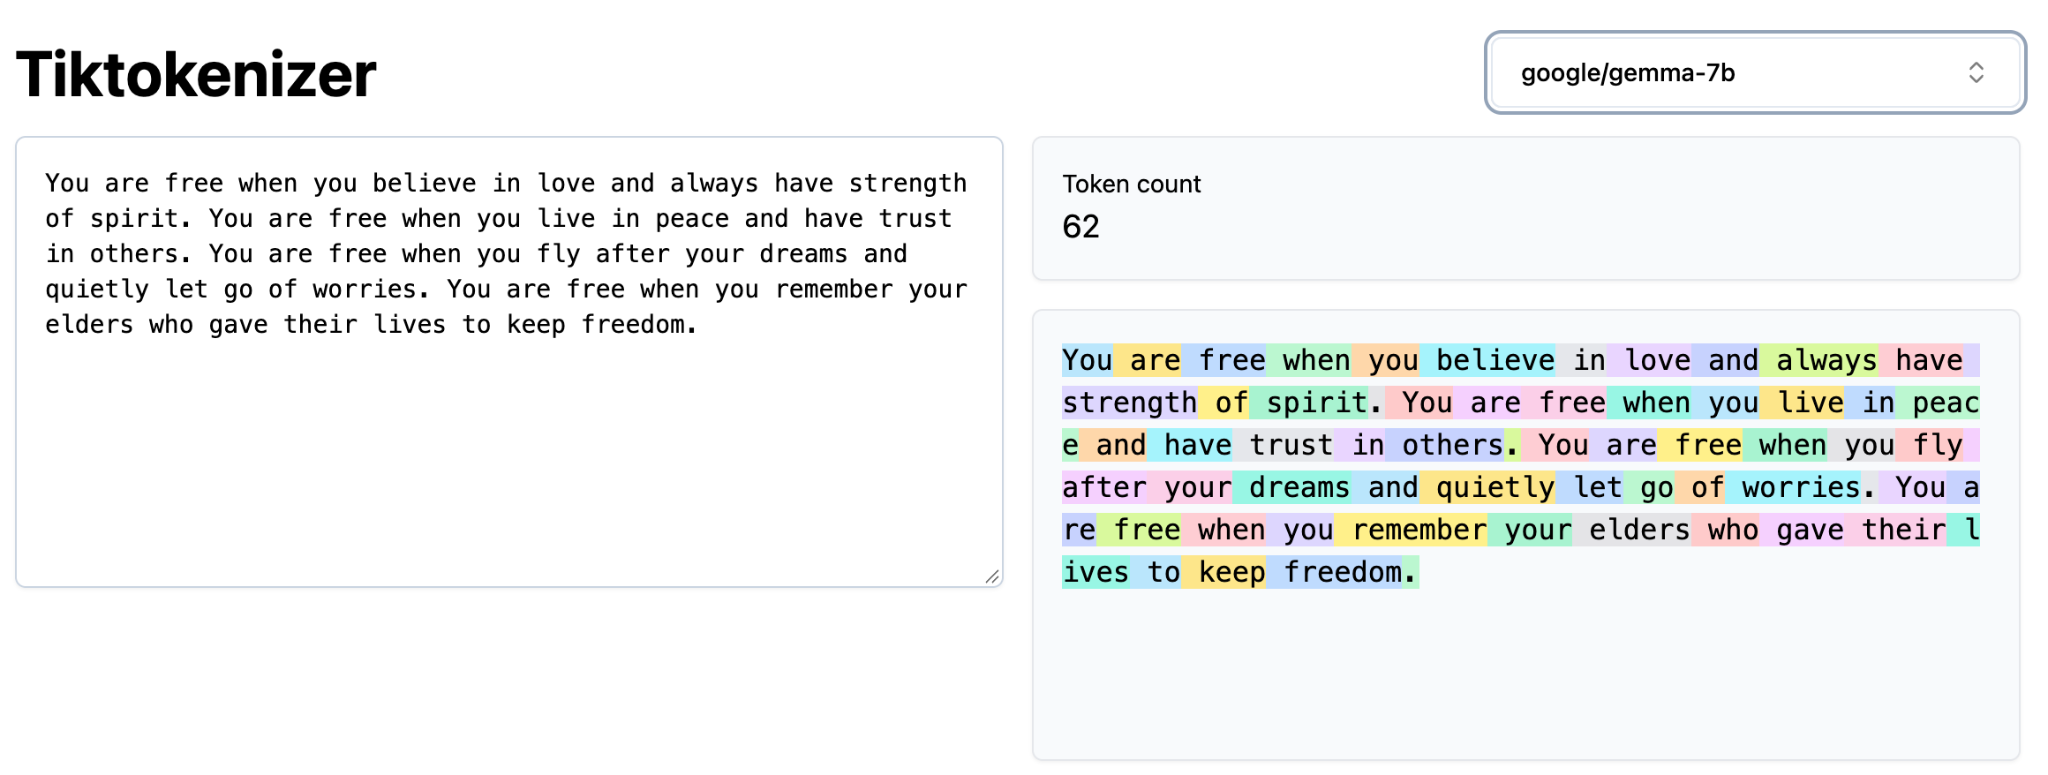
Figura 3: Benchmark empirico eseguito sul tokenizer di Google Gemma (256k vocabolario). Mentre Inglese e Italiano presentano una frammentazione quasi 1:1, il testo in dialetto Walser esplode istantaneamente.
4. L'Anatomia del Collasso: Il Caso "Noadengscht"
Cosa significa concretamente, a livello dei tensori, il tasso di inflazione di 2,60x dimostrato nei benchmark? Significa l'annientamento della semantica alla base della macchina.
Per comprendere la gravità di questo fenomeno, dobbiamo porre sotto la lente d'ingrandimento il verso più profondo della poesia di Luciana Favre: quello in cui la libertà è legata alla memoria degli avi ("Fri béscht wen noadengscht dine oalte..."). Osserviamo cosa accade all'interno del modello quando tenta di elaborare il verbo cardine di questa strofa: la parola Titsch "noadengscht" (seconda persona singolare: tu ricordi / tu rammenti).
Incapace di riconoscere l'integrità del termine, l'algoritmo SentencePiece / BPE è costretto a spezzarlo nel minimo comune denominatore statistico:
Una singola parola viva, custode di secoli di memoria alpina, viene fatta a pezzi in quattro sotto-token arbitrari. Ricevendo questi quattro frammenti, la matrice di embedding scarica quattro righe completamente sconnesse dalla sua tabella universale:
- Token |no|: Consulta la riga della parola inglese "no" — una coordinata con un massiccio carico vettoriale di negazione e rifiuto.
- Token |ad|: Consulta la riga dell'abbreviazione commerciale "ad" (advertisement) — puntando verso il cluster di media e pubblicità.
- Token |eng|: Consulta la riga associata alla radice di "engineering" o "English" — puntando a scienza applicata o lingua moderna.
- Token |scht|: Consulta una terminazione fonetica germanica residuale, priva di ancoraggio semantico autonomo.
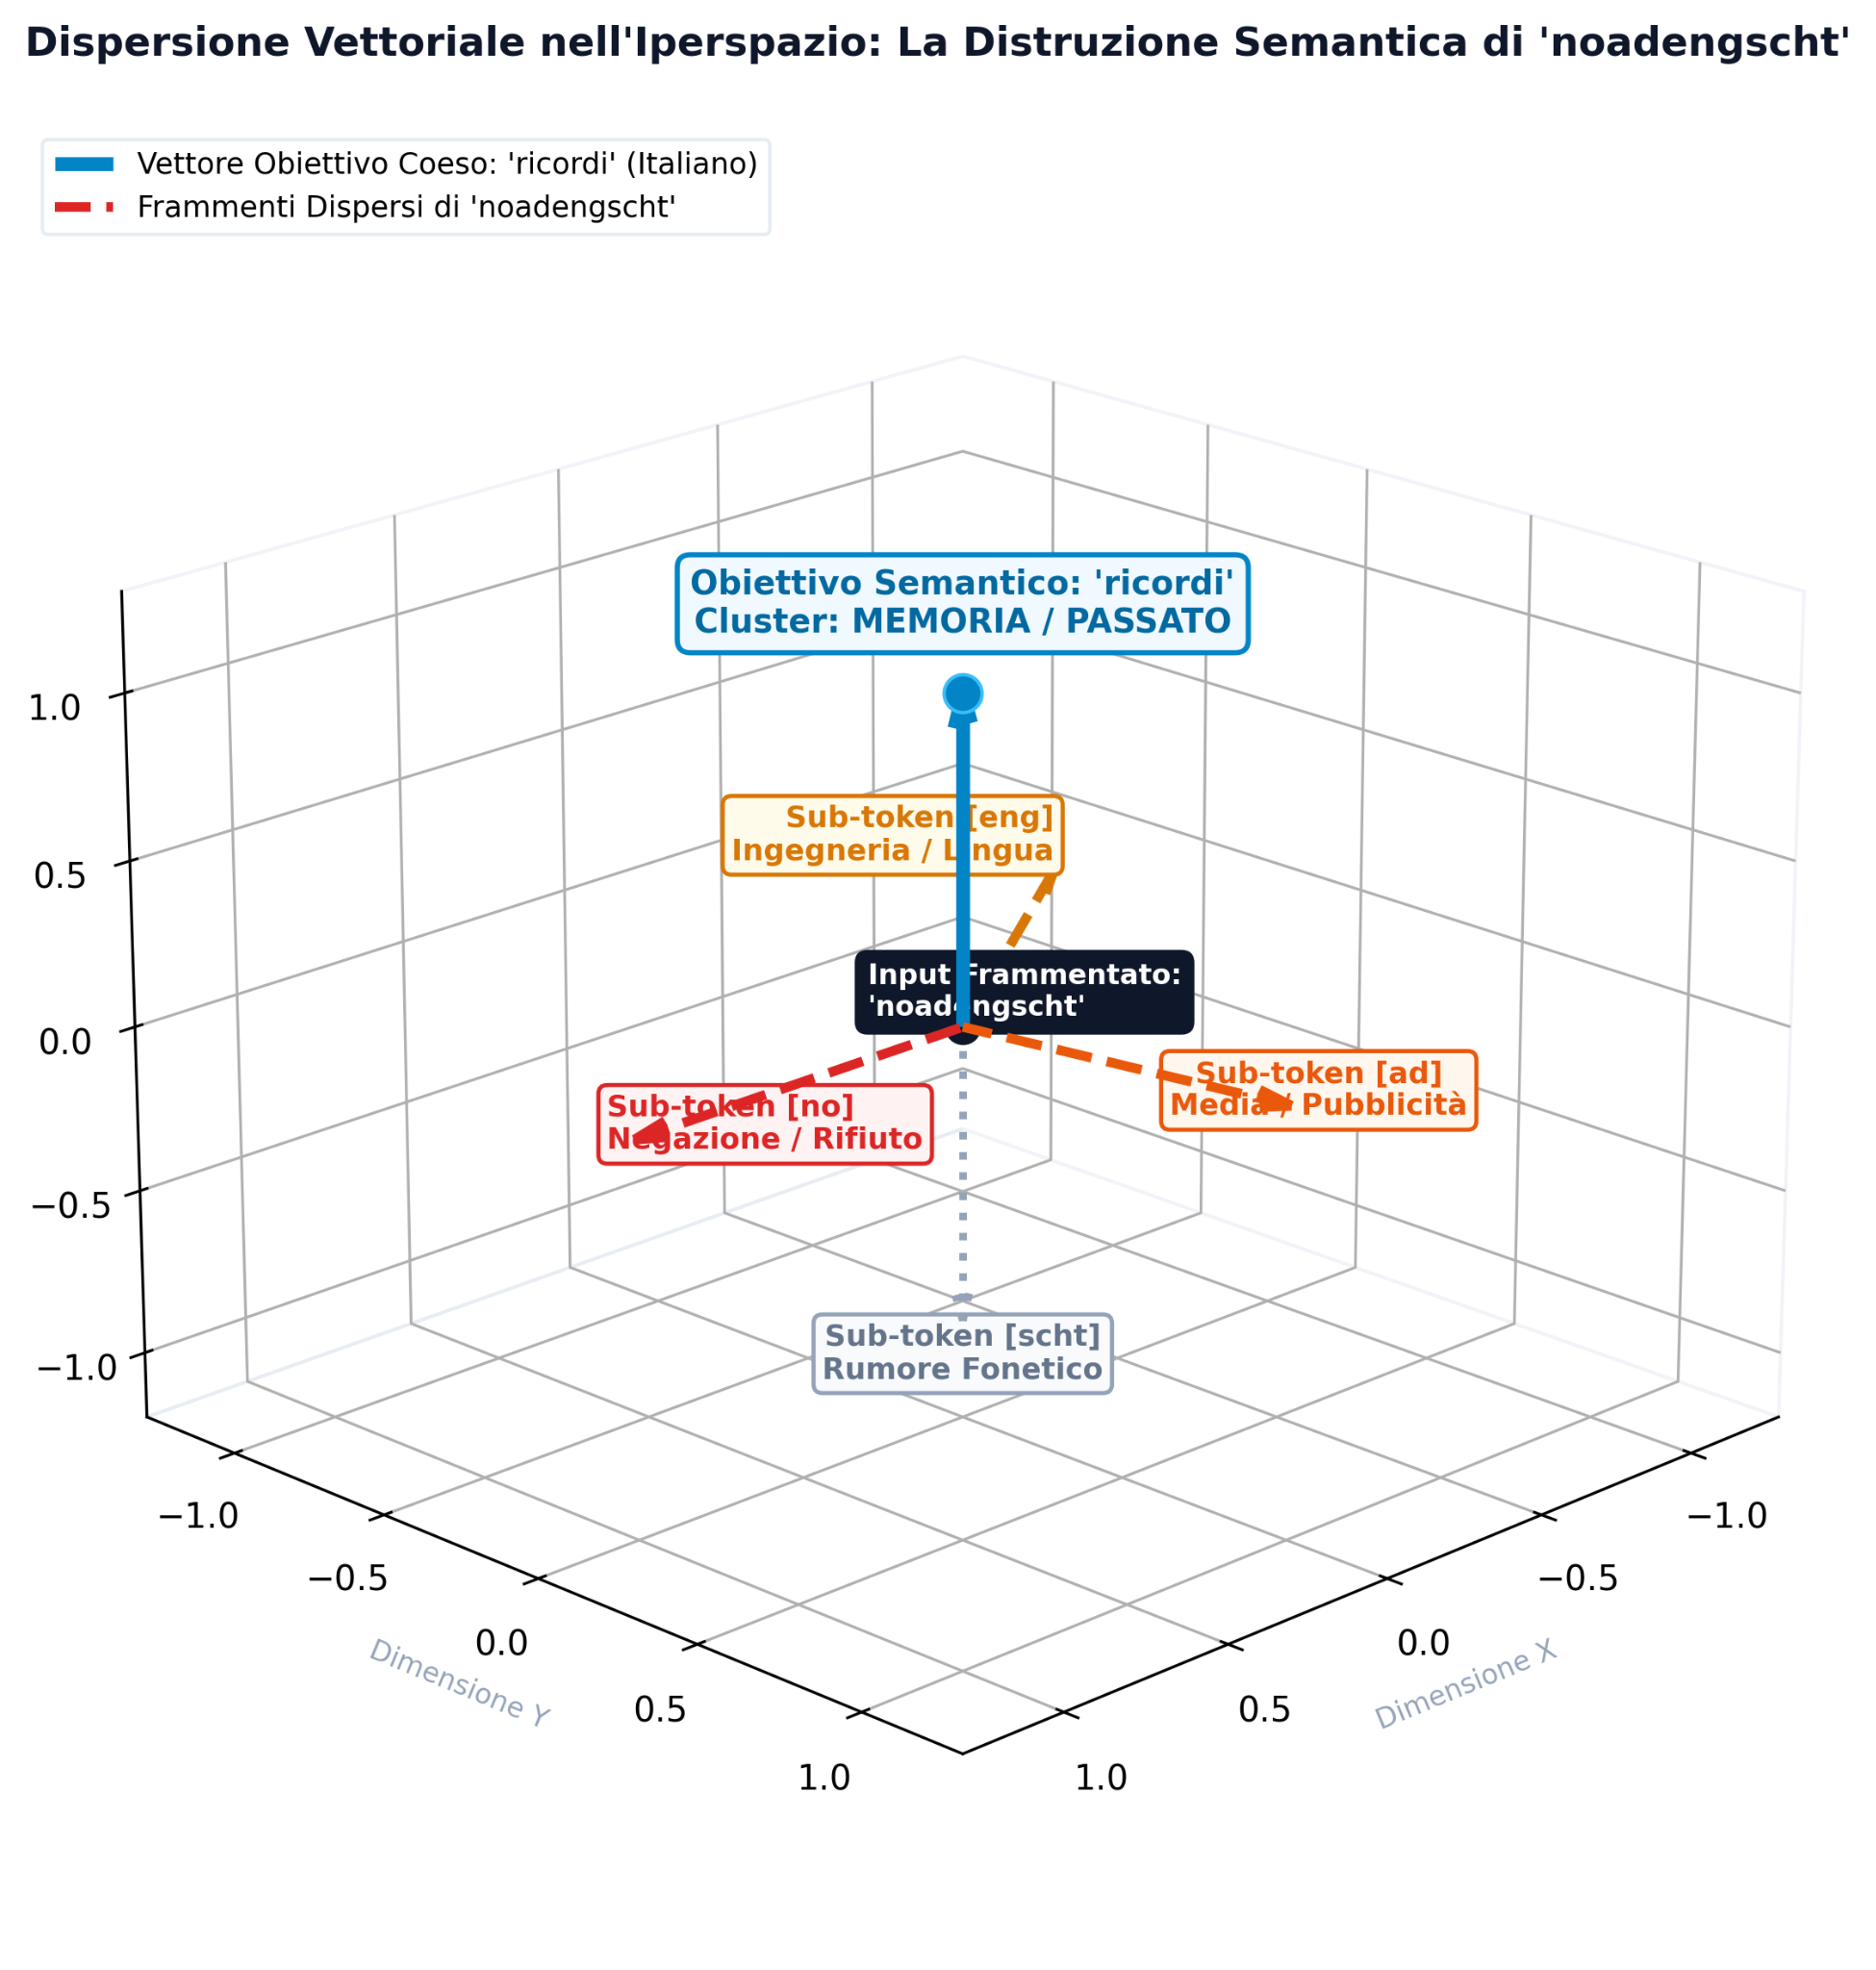
Il meccanismo successivo di Self-Attention del Transformer si trova costretto a compiere un calcolo titanico: lungo le decine di strati neurali del modello, deve calcolare matrici di attenzione su frammenti ortogonali tra loro, tentando di ricombinare un'idea che è stata corrotta prima ancora che il primo peso venisse moltiplicato.
5. Perché il Fine-Tuning Tradizionale (LoRA) Non Risolve il Problema
Di fronte a questo collasso, la reazione più comune tra ingegneri e data scientist è proporre una soluzione pronta all'uso: "Basta raccogliere i testi paralleli che possedete, formattarli in coppie di istruzioni ed eseguire un Fine-Tuning supervisionato con LoRA (Low-Rank Adaptation) su un modello open-source."
Questa premessa, sebbene allettante per il basso costo computazionale, si scontra con una limitazione fisica dell'architettura dei Transformer. Il metodo LoRA inietta matrici a basso rango principalmente nei livelli di attenzione:
Il punto cieco fatale: Nel pipeline classico di LoRA, la Matrice di Embedding di Ingresso rimane congelata al 100%. Anche se lo sviluppatore utilizza tecniche avanzate per scongelare gli embedding, il tokenizer di per sé non viene modificato.
1. Attention Capacity Waste
Le teste di attenzione sono progettate per ragionare sul contesto e sulle relazioni concettuali. Con token frammentati, sono costrette a sprecare parametri per fungere da "saldatori morfologici" di lettere isolate.
2. Costo Quadratico O(N²)
L'attenzione scala in modo quadratico. Con un'inflazione di 2.6x nei token, il costo computazionale e la latenza crescono vertiginosamente, esaurendo rapidamente la finestra di contesto della GPU.
3. Variazione Grafolinguistica
Nei manoscritti storici non esiste ortografia standardizzata. Una minima variante fonetica tra valli produce sequenze di sotto-token completamente diverse: l'adattatore LoRA fallisce e riprende ad allucinare.
Tentare di risolvere la rottura di un dialetto a basse risorse unicamente con il Fine-Tuning supervisionato via LoRA equivale a ridipingere le pareti di un edificio le cui fondamenta stanno cedendo.
6. La Destinazione: Berlino, AWS e NVIDIA
Per risolvere il problema dei dialetti storici e dei manoscritti alpini in modo definitivo, sapevamo di non poter restare alla superficie delle applicazioni software. Era imperativo scendere al livello dei compilatori, della riconfigurazione dei vocabolari e dell'infrastruttura hardware accelerata.
È con questo bagaglio di evidenze empiriche e benchmark che ho viaggiato a Berlino per prendere parte a una tavola rotonda a porte chiuse con i leader mondiali di intelligenza artificiale di AWS e NVIDIA. Il programma non riguardava chatbot convenzionali, bensì "Customizing Open Models — Nemotron and Beyond": le scelte di dati, valutazione e architettura che separano un semplice prototipo da una produzione su scala enterprise.
🎯 Il Dilemma Ingegneristico Posto al Tavolo di Berlino:
Di fronte a un dialetto a basse risorse in cui la frammentazione del tokenizer corrompe gli embedding alla base, qual è il playbook ingegneristico ottimale?
Dobbiamo eseguire un'Espansione Formale del Vocabolario nel Tokenizer seguita da Continual Pre-Training (CPT) su cluster accelerati AWS, oppure dobbiamo ancorare il modello tramite Generazione Massiva di Dati Sintetici e Modelli di Ricompensa (Reward Models) sfruttando l'architettura di NVIDIA Nemotron a partire dai nostri corpora paralleli storici?
La discussione sviluppatasi a Berlino non solo ha validato la nostra ipotesi matematica sulla dispersione degli embedding, ma ha delineato la rotta architetturale con cui ad AlpIA Tech ci prepariamo a restituire voce viva e intellegibile ai documenti e ai dialetti che il mondo digitale ha escluso dal suo addestramento originario.
I dettagli di questa architettura e le decisioni infrastrutturali tra silicio, dati sintetici e allineamento semantico saranno il fulcro del nostro prossimo articolo.
📚 Riferimenti Bibliografici e Fonti Tecniche
- Meta AI (2024). The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
- Google DeepMind (2024). Gemma 2: Improving Open Language Models at a Practical Size. arXiv preprint arXiv:2408.00118.
- Gemini Team, Google (2024). Gemini 1.5: Unlocking Multimodal Understanding Across Millions of Tokens of Context. arXiv preprint arXiv:2403.05530.
- Mistral AI Team (2024). Mistral Large 2 and the Architecture of Modern Open Tokenizers. Mistral Documentation & Hugging Face Repository.
- Meta AI (2024). Llama 3.3 Model Card & Weights Configuration. Meta AI Open Source.
- NVIDIA (2024). Nemotron-4 and Llama-3-Nemotron: Advanced Alignment and Synthetic Data Generation. NVIDIA NeMo Framework Documentation.
- OpenAI (2024). tiktoken: Fast BPE Tokeniser Library and o200k_base Encoding Specification. Repository Ufficiale GitHub.
- Anthropic (2024). The Claude 3.5 Model Family Architecture and System Card. Anthropic Research Publications.
Herica Welter
Fondatrice & Lead AI Architect @ AlpIA Tech
Progetta architetture avanzate di RAG, agenti conversazionali per aziende e modelli specializzati per la valorizzazione del patrimonio storico e documentale.
Hai archivi complessi, dialetti o documenti tecnici da valorizzare?
Costruiamo architetture RAG ed ecosistemi IA su misura per aziende, fondazioni e pubbliche amministrazioni, rispettando il contesto e la precisione filologica delle fonti.